De paradox van 95% nauwkeurigheid
Waarom kan AI met 95% juiste antwoorden toch onbruikbaar zijn?
AI met 95% juiste antwoorden kan onbruikbaar zijn wanneer de fouten precies de gevallen treffen die uw bedrijf moet herkennen. Het percentage vertelt hoeveel beoordelingen correct zijn, maar niet welke fouten worden gemaakt of wat daarvan de gevolgen zijn. Of de toepassing bruikbaar is, hangt ook af van de beslissingen die u eraan koppelt en de controle die nodig blijft.
Een leverancier presenteert een AI-toepassing met “95% nauwkeurigheid”. Dat klinkt overtuigend. Toch ontbreekt de informatie waarmee u als ondernemer een beslissing kunt nemen: wat werd getest, wat betekent “juist” en wat gebeurt er bij de overige 5%?
Een systeem dat mails helpt sorteren, moet aan andere voorwaarden voldoen dan een systeem dat zelfstandig beslist welke klant moet wachten.
95% juist, alle dringende mails gemist
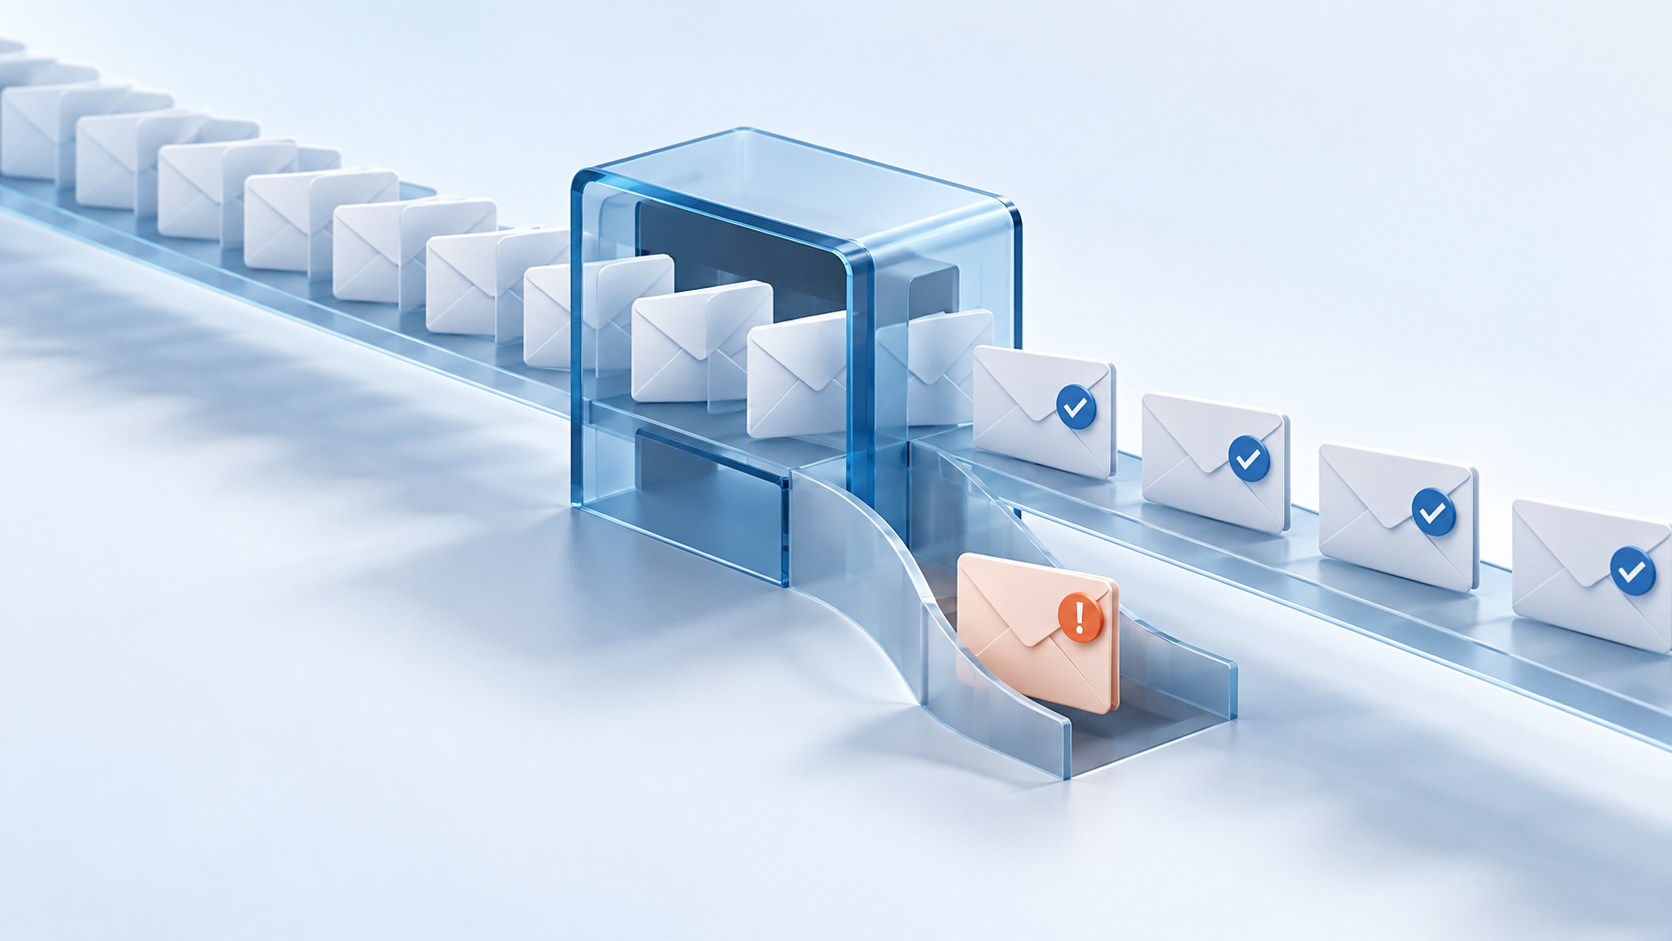
Stel dat een onderneming 1.000 servicemails ontvangt. Daarvan zijn er 50 dringend en 950 niet dringend. Een systeem dat elke mail als niet dringend bestempelt, beoordeelt 950 mails correct. De nauwkeurigheid bedraagt dus 95%.
Het vindt geen enkele dringende mail terug.
Dit is uiteraard slechts een rekenvoorbeeld. Het illustreert vooral waarom een totaalpercentage misleidend kan zijn wanneer de gevallen die u wilt herkennen weinig voorkomen. De vele gewone gevallen bepalen dan de score, terwijl de uitzonderingen juist de reden kunnen zijn om AI in te zetten.
Welke fouten zitten achter het percentage?
Neem dezelfde 1.000 mails, maar nu met een systeem dat 80 mails als dringend markeert. Daarvan zijn er 40 werkelijk dringend. Het systeem geeft dus 40 onterechte waarschuwingen en mist 10 dringende mails. De overige 910 niet-dringende mails worden correct ingedeeld.
De nauwkeurigheid bedraagt opnieuw 95%: 40 plus 910 correcte beoordelingen op 1.000 mails.
Drie meetbegrippen maken het verschil zichtbaar:
| Maatstaf | Wat meet u in dit voorbeeld? | Resultaat |
|---|---|---|
|
Accuracy Totale nauwkeurigheid |
Welk aandeel van alle mails wordt correct ingedeeld? | 950 op 1.000: 95% |
|
Precision Juistheid van de waarschuwingen |
Welk aandeel van de als dringend gemarkeerde mails is werkelijk dringend? | 40 op 80: 50% |
|
Recall Volledigheid van de herkenning |
Welk aandeel van alle werkelijk dringende mails wordt gevonden? | 40 op 50: 80% |
Deze begrippen komen uit de beoordeling van classificaties: systemen die gevallen in categorieën indelen. U moet twee soorten fouten uit elkaar houden: onterecht waarschuwen en een belangrijk geval missen.
In dit voorbeeld mist het systeem één op de vijf dringende mails. Bovendien is de helft van de waarschuwingen onterecht. Dat zegt meer over de bruikbaarheid dan het totaalpercentage.
Uw beslissing bepaalt welke fout aanvaardbaar is
Als de toepassing medewerkers helpt hun inbox te prioriteren en alle mails binnen de afgesproken termijn nagekeken blijven worden, kan ze nuttig zijn. De dringende gevallen die ze herkent, komen sneller onder de aandacht.
Als alleen gemarkeerde mails onmiddellijk worden behandeld en alle andere automatisch mogen wachten, krijgen dezelfde tien missers een ander gewicht. Ze kunnen bijvoorbeeld een gemiste interventie of een klant zonder tijdig antwoord betekenen.
Ook onterechte waarschuwingen hebben een kost. Medewerkers moeten ze beoordelen. Wanneer die controle veel tijd vraagt, kan de beloofde tijdwinst verdwijnen.
Onze beoordeling begint daarom bij de beslissing die u wilt toevertrouwen aan de toepassing. Wat mag ze voorstellen? Wat mag ze zelfstandig uitvoeren? Wie grijpt in wanneer iets fout loopt? Die afspraken horen in het ontwerp, voordat er gebouwd wordt.
Meer menselijke controle is daarbij geen automatische oplossing. Als medewerkers elk resultaat volledig opnieuw moeten onderzoeken, kan de toepassing te weinig voordeel opleveren.
Is “juist” wel duidelijk afgesproken?
Een kwaliteitsmeting veronderstelt dat u weet wat een juist resultaat is. Hier gaan we verder op in.
Is een klacht van een belangrijke klant altijd dringend? Of pas wanneer de dienstverlening stilvalt? Wat als twee medewerkers daar verschillend over oordelen?
Dan meet u deels onduidelijke bedrijfsafspraken. Eerst moet vaststaan welke criteria gelden en wie twijfelgevallen beoordeelt.
Ook de beschikbare informatie speelt mee. “Sinds gisteren is het weer hetzelfde” zegt op zichzelf weinig. Met de klantgeschiedenis erbij kan duidelijk worden dat het om een terugkerende storing gaat waarvoor onmiddellijk ingrijpen was afgesproken.
Een test met alleen expliciete storingsmeldingen beantwoordt dus niet de vraag of de toepassing zulke berichten goed behandelt. Neem ook onvolledige mails, eerdere correspondentie en uitzonderingen op in de proef.
Bij een AI-agent moet u de volledige taak beoordelen
Een AI-agent kan bijvoorbeeld een mail lezen, klantgegevens opzoeken, een ticket aanmaken en een antwoord versturen. Een correcte indeling als “dringend” bewijst dan nog niet dat de volledige taak goed verloopt.
In een proef moet u ook nagaan of de agent de juiste klant selecteert, de benodigde informatie gebruikt, binnen zijn bevoegdheden handelt en de actie correct vastlegt. De hiervoor beschreven meetbegrippen helpen bij onderdelen die categorieën voorspellen. Ze zijn geen volledige kwaliteitsmaatstaf voor een agent.
Bepaal daarom vooraf wat een geslaagde afhandeling betekent. Een correct geformuleerd antwoord bij het verkeerde klantdossier blijft een fout.
Vergelijk met het werk zoals het vandaag gebeurt
AI hoeft niet foutloos te zijn om verbetering te brengen. Ook de huidige werkwijze kan dringende mails missen, verkeerde prioriteiten stellen of veel controletijd vragen.
Vergelijk daarom het volledige proces vóór en tijdens de proef. Meet tijdige afhandeling, ernstige missers en benodigde controle. Neem ook een eenvoudiger alternatief mee: kunnen duidelijke routeringsregels of betere werkafspraken het probleem voldoende oplossen?
We adviseren steeds om eerst meetcriteria te bepalen en eenvoudige oplossingen als vertrekpunt te gebruiken. Dat zorgt voor een bruikbare basis om te vergelijken.
Wat kunt u vóór een investering doen?
Kies één concrete taak en leg vast welke fouten de grootste gevolgen hebben. Verzamel representatieve voorbeelden en bepaal wanneer de proef geslaagd is. Laat tijdens die proef de bestaande opvolging doorlopen en controleer ook gevallen die de AI niet markeert. Zo blijven gemiste gevallen in beeld.
U hoeft niet vooraf te weten welk percentage “goed genoeg” is. U moet wel kunnen beoordelen of de nieuwe werkwijze, met alle controles erbij, beter werkt dan de huidige en binnen uw risicogrenzen blijft.
Wilt u die voorwaarden voor een concrete toepassing scherpstellen? We onderzoeken met u het proces, de gegevens en de beslissingen, zodat duidelijk wordt wat u kunt automatiseren en welke controle nodig blijft.